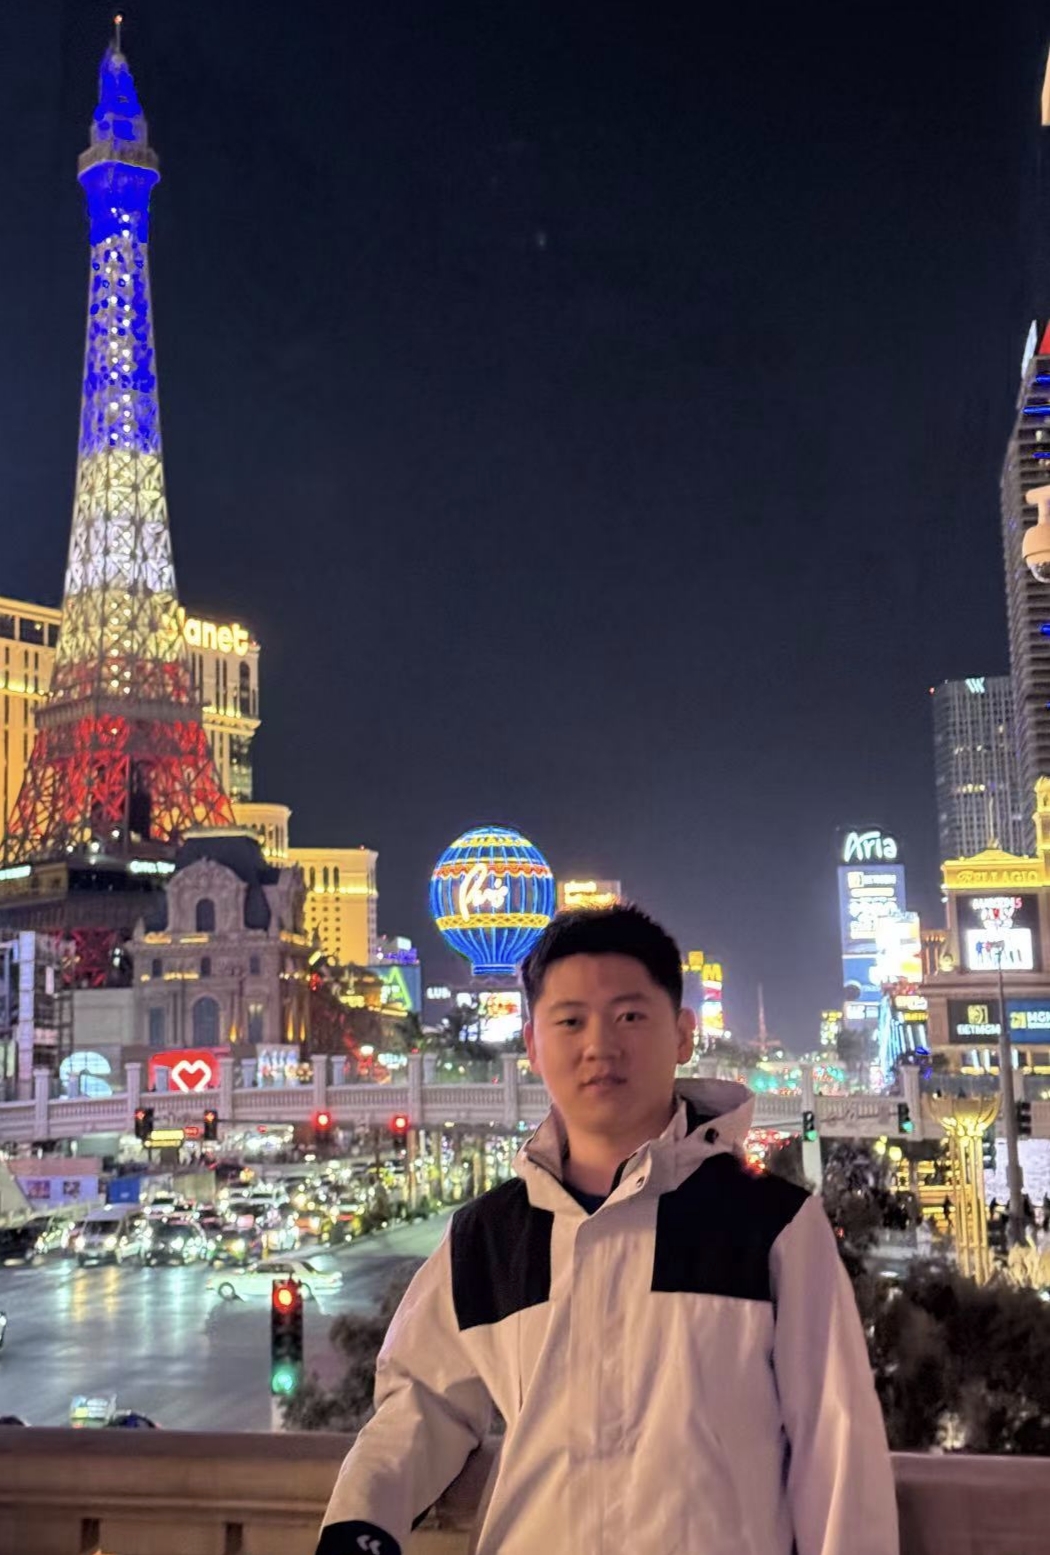
Wenju Zhao (赵文举)
Wenju Zhao (赵文举) is a PhD candidate in the School of Computer Science and Technology at Huazhong University of Science and Technology, advised by Prof. Xiaofei Liao. He conducts his research within the Key Laboratory of Services Computing Technology and System, Ministry of Education (CGCL). Prior to his PhD, he received his bachelor’s degree in Data Science and Big Data Technology from Wuhan University of Technology (2018–2022).
His research focuses on efficient AI acceleration, particularly on the co-design of algorithms and hardware for Large Language Models (LLMs) and Graph Neural Networks (GNNs). He also works on model compression techniques such as quantization and pruning, which complement his system-level designs by reducing computational and memory demands. Overall, his work aims to develop more efficient architectural support for modern AI inference workloads.
I am seeking industry positions or postdoctoral opportunities in efficient AI inference, model compression, and computer architecture. Please feel free to contact me if you have suitable opportunities.
📖 Education
-
2026.08 – 2027.06: Visiting Scholar, School of Computing, National University of Singapore; Supervised by Prof. Bingsheng He; Working on machine learning acceleration.
-
2022.06 – 2027.04: PhD Candidate in Computer Science, Huazhong University of Science and Technology; Supervised by Prof. Xiaofei Liao; GPA: 3.77/4; Rank: 1/11
-
2018.09 – 2022.06: Bachelor of Engineering in Data Science and Big Data Technology, Wuhan University of Technology; GPA: 4.317/5; Rank: 1/33
📝 Publications (first author, co-first author*, student first author#)
- [MICRO 2026] SkewQ: Skewness-Aware Cross-Layer Quantization for Efficient LLM Inference via Software-Hardware Co-Design
Wenju Zhao, Jianhui Yue, Pengcheng Yao, Jiaqi Zhai, Yundong Zhang, Yu Huang, Shunsen Lv, Bing Zhu, Zhongtian Long, Chencheng Ye, Lihong Gu, Jingling Xue, Hai Jin, and Xiaofei Liao
The International Symposium on Microarchitecture (CCF-A Conference, Top Tier Conference in Computer Architecture) - [DAC 2026] FuseDot: A Multiplication-Fused Dot Product Accelerator for Efficient LLM Inference
Wenju Zhao, Jianhui Yue, Pengcheng Yao, Yujia Cui, Qinggang Wang, Yufei Sun, Jiaqi Zhai, Hai Jin, and Xiaofei Liao
The Chips to Systems Conference (CCF-A Conference, Top Tier Conference in EDA) - [HPCA 2025] MeHyper: Accelerating Hypergraph Neural Networks by Exploring Implicit Dataflows
Wenju Zhao, Pengcheng Yao, Dan Chen, Long Zheng, Xiaofei Liao, Qinggang Wang, Shaobo Ma, Yu Li, Haifeng Liu, Wenjing Xiao, Yufei Sun, Bing Zhu, Hai Jin, and Jingling Xue
The International Symposium on High-Performance Computer Architecture (CCF-A Conference, Top Tier Conference in Computer Architecture) - [TCAD 2026] HyperPIM: A Redundancy-Aware Heterogeneous PIM Accelerator for Hypergraph Neural Networks
Zhongtian Long*, Wenju Zhao*, Mo Zou, Hongrui Guo, Jin Zhao, Qiyuan Niu, Yutao Fu, Shunsen Lv, Zixiao Wang, Yuluo Guo, Yongwei Zhao, Yu Zhang, and Hai Jin
IEEE Transactions on Computer-Aided Design of Integrated Circuits and Systems (CCF-A Journal) - [JCST 2024] Towards High-Performance Graph Processing: From a Hardware/Software Co-Design Perspective
Xiaofei Liao, Wenju Zhao#, Hai Jin, Pengcheng Yao, Yu Huang, Qinggang Wang, Jin Zhao, Long Zheng, Yu Zhang, and Zhiyuan Shao
Journal of Computer Science and Technology (CCF-B Journal, Cover Article) - [PPoPP 2027] EvoCG: Self-Evolving Precision Control for Faster Conjugate Gradient
Jiaqi Zhai, Haozhi Han, Kaiyi Huang, Wenju Zhao, Yifeng Chen, Yunquan Zhang, Ting Cao, Yunxin Liu, Hai Jin, Xuanhua Shi, and Kun Li
The ACM SIGPLAN Annual Symposium on Principles and Practice of Parallel Programming (CCF-A Conference, Top Tier Conference in Computer Systems) - [TACO 2027] DeGCN: Accelerating Inference for Deep Graph Convolutional Networks by Exploiting Feature Similarity
Shunsen Lv, Jianhui Yue, Yu Zhang, Jiaqi Zhai, Jiangqiu Shen, Zhongtian Long, Wenju Zhao, Hai Jin, and Xiaofei Liao
ACM Transactions on Architecture and Code Optimization (CCF-A Journal) - [arXiv 2026] ActTune: Action-Aware Precision and GPU Operating-Point Adaptation for Energy-Efficient Vision-Language-Action Inference
Zou Qingyun, Bin Gao, Wenju Zhao, Weng-Fai Wong, Bingsheng He, and Tulika Mitra
arXiv preprint - [arXiv 2026] From Splats to Silicon: Rethinking Computational Efficiency of 3DGS
Minnan Pei, Qiwei Dong, Yihan Zhou, Gang Li, Yuchen Zhu, Wenju Zhao, Zhongtian Long, Siting Wang, Peisong Wang, and Jian Cheng
arXiv preprint - [ICCD 2026] ReHyper: A Redundancy-Eliminated Accelerator for Dynamic Hypergraph Neural Networks
Zhongtian Long, Mo Zou, Qiyuan Niu, Wenju Zhao, Yutao Fu, Jiaqi Zhai, Shunsen Lv, Zixiao Wang, Yuluo Guo, Yuanyuan Liang, Hongrui Guo, Jin Zhao, and Yu Zhang
IEEE International Conference on Computer Design (CCF-B Conference) - [TCAD 2026] SpecTwin: Accelerating Tree-based Speculative Decoding via Differential Token Quantization
Yufei Sun, Pengcheng Yao, Long Zheng, Yundong Zhang, Yu Huang, Qinggang Wang, Huize Li, Wenju Zhao, Bing Zhu, Haifeng Liu, Xiaofei Liao, and Hai Jin
IEEE Transactions on Computer-Aided Design of Integrated Circuits and Systems (CCF-A Journal) - [MICRO 2026] RAIL: A Reconfigurable Spatial Accelerator for Linear-Time Sequence Model Inference
Xinyu Zhu, Qinggang Wang, Wenju Zhao, Bing Zhu, Runze Wang, Long Zheng, Xiaofei Liao, Hai Jin, and Jingling Xue
The International Symposium on Microarchitecture (CCF-A Conference, Top Tier Conference in Computer Architecture) - [ISCA 2026] ParetoES: Hardware-Accelerated Sparse Embedding Similarity via Pareto-Optimal Pruning
Jiaqi Zhai, Xuanhua Shi, Wenju Zhao, Kaiyi Huang, Chencheng Ye, Shunsen Lv, Zhongtian Long, Bingsheng He, and Hai Jin
The International Symposium on Computer Architecture (CCF-A Conference, Top Tier Conference in Computer Architecture) - [SSI 2026] A High-Efficiency 3D-Stacked Accelerator for Deep Graph Neural Network Inference
Zhongtian Long, Yu Zhang, Yutao Fu, Qiyuan Niu, Shunsen Lv, Jiaqi Zhai, Wenju Zhao, Yingqi Zhao, and Hai Jin
Scientia Sinica Informationis (CCF-T1 Journal) - [TACO 2025] PRAGA: A Priority-Aware Hardware/Software Co-design for High-Throughput Graph Processing Acceleration
Long Zheng, Bing Zhu, Pengcheng Yao, Yuhang Zhou, Chengao Pan, Wenju Zhao, Xiaofei Liao, Hai Jin, and Jingling Xue
ACM Transactions on Architecture and Code Optimization (CCF-A Journal)
⭐ Academic Achievements
- 2026.06: Best Paper Award, FuseDot: A Multiplication-Fused Dot Product Accelerator for Efficient LLM Inference. 4th CS Academic Annual Conference, HUST, China.
- 2025.09: Invited Talks, MeHyper: Accelerating Hypergraph Neural Networks by Exploring Implicit Dataflows. Session 3: GPU and Domain Specific Accelerator Architectures, CCFSys 2025, Beijing, China.
- 2024: Cover Article, Journal of Computer Science and Technology (Work on high performance graph processing).
- 2022: Outstanding Undergraduate Thesis, Parallel Optimization of Sparse Triangular Matrix Solution Based on Shared Memory, Wuhan University of Technology.
🎖 Honors and Services
- 2026: ISCA’26 Artifact Evaluation Committee
- 2026, 2024, 2020: National Scholarship, Ministry of Education, China
- 2024: Science and Technology Innovation Scholarship, Huazhong University of Science and Technology
- 2023, 2022: First Class Doctoral Scholarship, Huazhong University of Science and Technology
- 2021: Outstanding Scholarship, Wuhan University of Technology (highest honor of the university, Top 0.1%)
- 2021: Mathematical Contest in Modeling – Meritorious Winner
- 2021: China Undergraduate Mathematical Contest in Modeling – Second Prize